
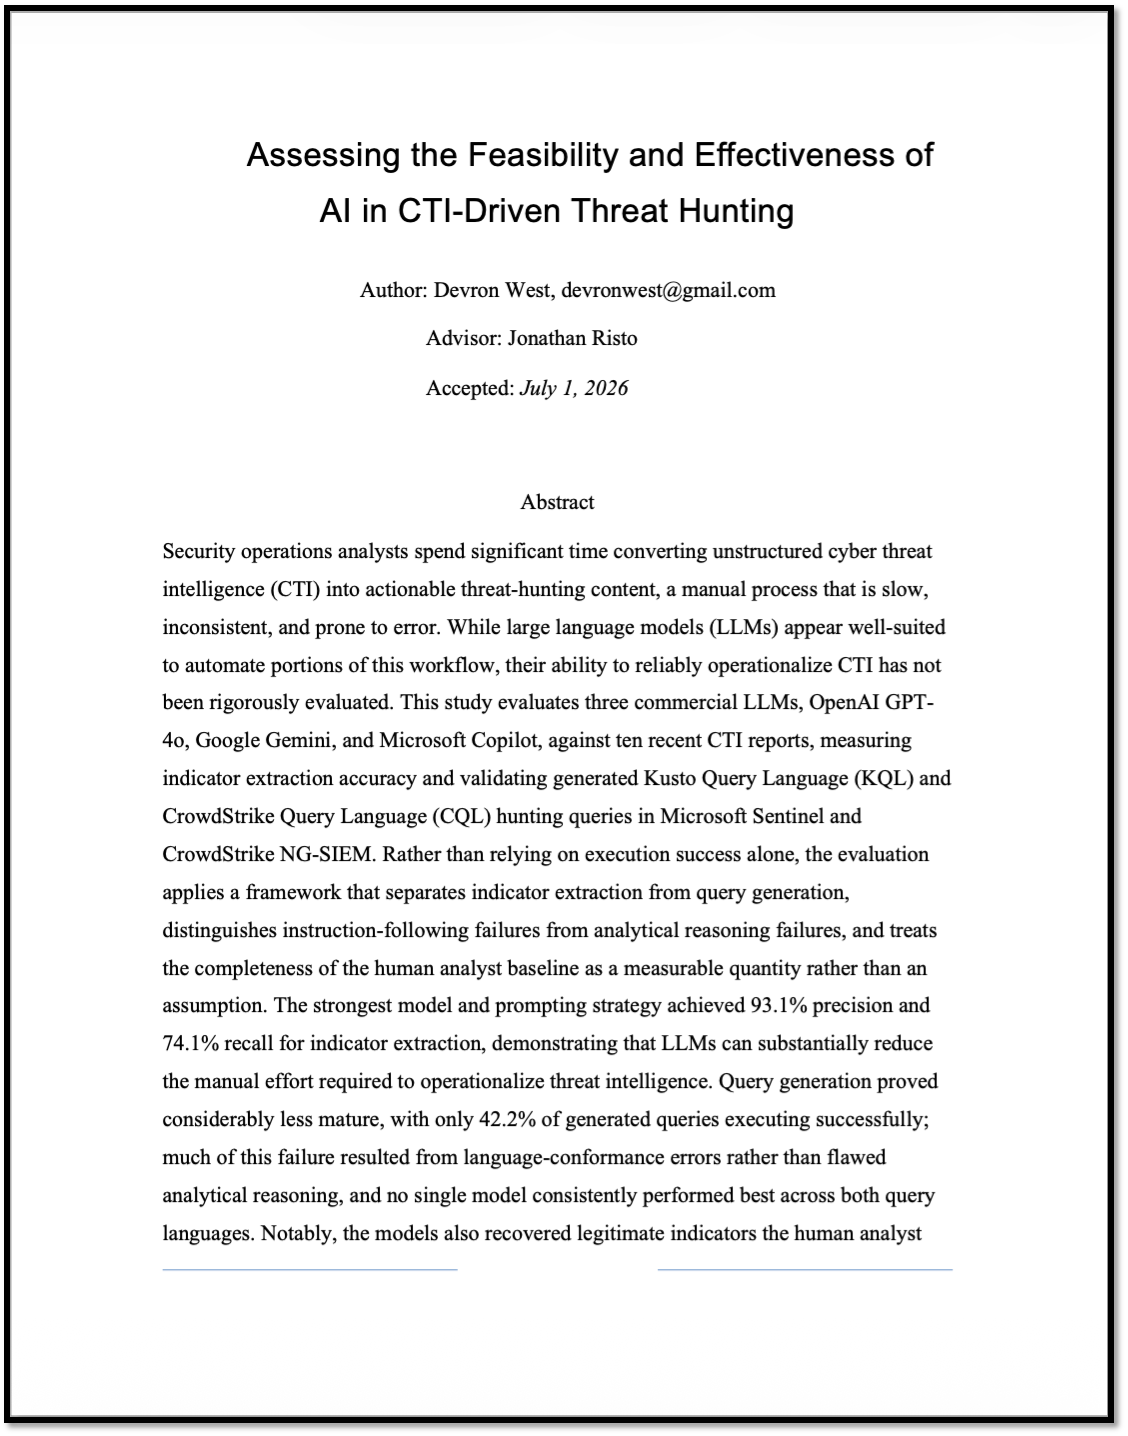
La conversión de inteligencia de amenazas cibernéticas no estructurada en detecciones y consultas de threat hunting accionables constituye un proceso manual exigente que deja poco margen de error. Los analistas deben distinguir infraestructura del atacante de entornos de víctima, clasificar correctamente los indicadores y traducir ese entendimiento a lógica específica de plataforma antes de que la inteligencia pierda relevancia. Ante el aumento del volumen de CTI disponible, este cuello de botella limita la velocidad de respuesta de los centros de operaciones de seguridad. Los modelos de lenguaje grandes ofrecen una vía potencial de automatización, puesto que interpretan texto no estructurado, identifican relaciones contextuales y generan salidas estructuradas a partir de instrucciones en lenguaje natural. Sin embargo, su capacidad para operacionalizar de manera confiable reportes de CTI completos no había sido evaluada de forma rigurosa hasta este estudio.
Se seleccionaron tres modelos comerciales de uso general, OpenAI GPT-4o, Google Gemini y Microsoft Copilot, y se evaluaron frente a un corpus de diez reportes de CTI de distinta estructura, profundidad técnica y escenarios de amenaza. Cada documento se estandarizó a texto plano para eliminar el formato como variable confusora. Se aplicaron dos estrategias de prompting fijas de antemano: un prompt único que solicita extracción de indicadores y generación de consultas en una sola interacción, y un prompt dividido que separa ambas tareas. La extracción se midió mediante precisión, recall y F1 respecto a una línea base construida por un analista humano. Las consultas generadas se ejecutaron en Microsoft Sentinel y CrowdStrike NG-SIEM y se clasificaron por validez de ejecución, relevancia analítica y conformidad lingüística. Un marco de codificación estructurado distinguió indicadores fabricados, errores de transcripción e indicadores legítimos omitidos por la línea base, así como fallos de instrucción frente a fallos de razonamiento.
Los resultados muestran un contraste claro entre las dos tareas. La extracción de indicadores alcanzó niveles operativos útiles: el mejor combinación de modelo y prompt logró 93,1 % de precisión y 74,1 % de recall. La generación de consultas, en cambio, solo logró una tasa de ejecución exitosa del 42,2 %. Gran parte de los fallos en CQL se debió a consultas escritas en el dialecto incorrecto, no a un razonamiento analítico deficiente. Ningún modelo dominó de forma consistente ambas plataformas. De manera significativa, varios modelos recuperaron indicadores auténticos presentes en los reportes pero omitidos por el analista humano, lo que revela tanto el potencial complementario de los LLM como la incompleteness de las líneas base humanas tradicionales. En el reporte de control sin indicadores atómicos, los modelos evitaron fabricar infraestructura inexistente y generaron búsquedas conductuales alineadas con el tradecraft documentado.
Estas evidencias orientan un uso práctico de los LLM como asistentes de analista más que como sustitutos. Su mayor valor actual reside en acelerar la fase de extracción de indicadores, mientras que la generación de consultas listas para producción requiere revisión humana obligatoria. La elección del modelo debe alinearse con la plataforma de detección, el diseño de prompts debe especificar explícitamente el lenguaje y el esquema disponibles, y la estrategia de prompting debe reflejar las prioridades operativas de cobertura versus precisión. El marco de evaluación desarrollado, que separa extracción de generación, distingue conformidad lingüística de razonamiento y cuantifica la completitud de la línea base, constituye un aporte metodológico reutilizable para evaluar generaciones futuras de modelos en el mismo contexto de threat hunting impulsado por CTI.
Para leer más ingrese a:
https://www.sans.org/white-papers/assessing-feasibility-effectiveness-ai-cti-driven-threat-hunting
Compartir artículo
Para información general sobre la organización: difusion@colombiainteligente.org | Dirección: Edf. TecnoParque Cr 46#56-11 Piso 13 | Medellín – Colombia
Teléfono: +57-4-4441211 Ext. 171 | FAX: +57-4-4440460

Los documentos se clasifican en varios colores tipo semáforo tecnológico que indican el nivel de implementación de la tecnología en el país
Tecnología en investigación que no ha sido estudiado o reglamentado por entidades del sector.
La tecnología se aplica de manera focal y se encuentra en estudio por parte de las entidades del sector.
La tecnología se aplica de manera escalable y se encuentran políticas y regulaciones focales establecidas.
La tecnología se aplica a través de servicios y se encuentran políticas y regulaciones transversales establecidas.
La tecnología se aplica de manera generalizada y se tiene un despliegue masivo de esta.
Para acceder a todos los documentos publicados y descargarlos ingresa aquí